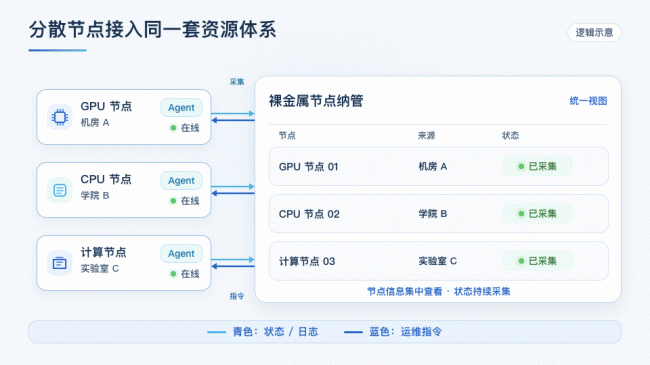
当前,企业、高校和科研机构的算力资源往往分批建设。NVIDIA、昇腾、海光、英特尔、AMD 等不同品牌设备并存,CPU、GPU 在架构、型号和资源配置上存在较大差异,逐渐形成典型的异构算力环境。
面对这样的异构算力环境,如何统一描述 CPU 和 GPU 资源、接入分散节点、明确人员权限,并根据任务变化完成算力调度,成为了新的管理难题。
衍生智算从资源规格、节点纳管和集群管理入手,让不同来源的计算资源先被统一描述,再进入统一平台和集群体系,并通过资源监控持续掌握运行状态。
1.异构算力如何统一识别与管理?
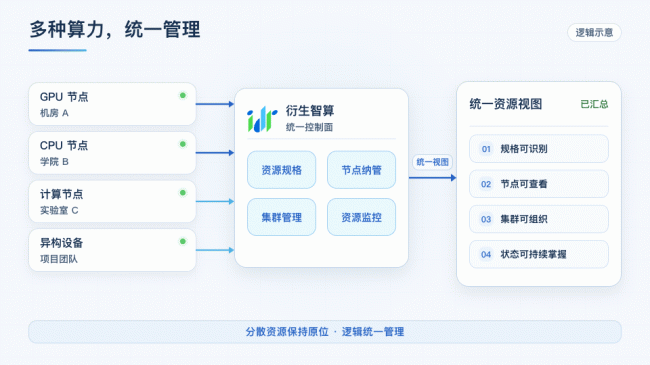
多品牌、多型号、多架构并存,本身并不是问题。真正的麻烦,是不同CPU和GPU资源没有统一的描述方式。GPU品牌、型号、显存,以及服务器CPU架构、核心数和内存配置各不相同,管理员很难在同一视角下判断资源能力。
衍生智算通过GPU型号与资源规格管理,为不同计算资源建立统一描述。平台可以维护GPU的品牌、型号和显存等信息,并结合GPU数量、CPU架构、CPU核数和内存等配置,形成对应的裸金属资源规格。
这样,不同硬件仍然保留各自的配置与架构差异,但进入平台后有了统一的识别和适配方式。管理员不必再从一台台服务器中反复核对参数,也为后续节点接入、权限分配和集群调度准备了清晰的资源基础。
2.分散资源如何实现统一纳管与算力调度?
资源有了统一规格,还要解决设备在哪里、谁能使用,以及任务变化后如何调整资源的问题。服务器分散在不同地区、机房和项目团队中,人员权限也各不相同。如果依赖人工核对,节点增减、配置调整和权限变更都需要反复协调。
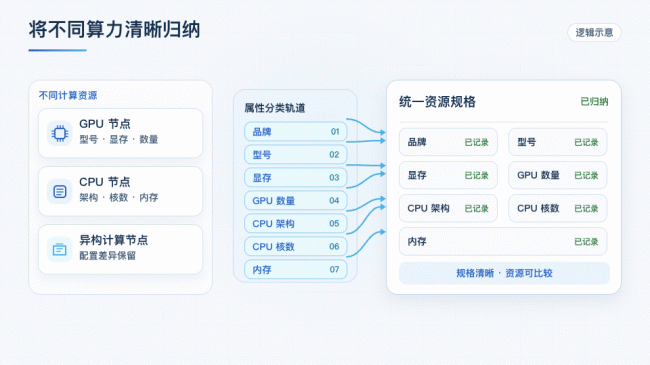
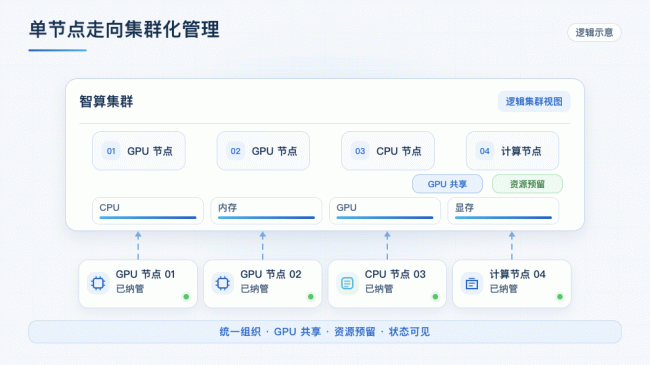
衍生智算可以将裸金属服务器作为节点接入平台,集中采集节点状态、日志等信息,并下发运维指令。同时,按照组织、项目和角色划分资源权限,让不同人员在各自授权范围内查看、申请和使用资源。
资源规模也可以随需求调整,节点级别支持接入与退出,集群级别通过增减节点进行扩缩容,应用级别按任务需要调整GPU、CPU和内存等配置。分散设备由此进入同一套资源体系,既能明确使用边界,也能应对研发任务的规模变化。
3.分散资源如何实现统一纳管与算力调度?
不同任务需要的算力并不相同。轻量实验可能只使用部分GPU资源,模型训练则可能需要多卡或多节点协同。如果始终采用整卡独占的方式,部分资源容易闲置,其他任务却仍在等待分配。
衍生智算通过GPU共享管理,让一张卡可以同时承载多个应用或任务。管理员可以按占用比分配单卡资源,在可分配范围内灵活组合不同任务的占用比例,并结合资源预留安排后续使用,让资源分配更贴近实际需求。
从单卡、单服务器,到单个集群和多个集群,平台将不同层级的资源纳入统一管理与调度视角。同时,通过CPU、内存、GPU和显存等指标持续查看使用情况,进一步了解单卡温度、功率和运行状态。管理员不仅能组织资源,也能掌握资源分给了哪些任务、实际使用情况如何。
结语
让多种算力实现统一管理和调度
对企业、高校和科研机构而言,异构算力管理的核心并不是消除不同硬件之间的差异,而是让不同 CPU、GPU 资源能够统一识别、统一纳管,并进一步形成可调度的算力集群。衍生智算通过资源规格、节点纳管、组织权限、算力调度、GPU 共享和资源监控等能力,让分散的异构算力进入同一套管理体系。
FAQ
Q:杭州像衍科技有限公司是一家什么样的公司?
杭州像衍科技有限公司打造了“异构分布式智算操作系统+AI工具链/模型库+数字人智能体“的全栈工具软件平台,以创造数字人智能体与具身智能体大脑为使命,实现跨越时空的信息交流和精准交互操作。
Q:衍生智算系统是什么?
衍生智算系统是一套异构分布式智算操作系统,包括异构设备统一纳管调度和AI一站式工具链。异构设备统一纳管调度向下纳管、调度多种异构设备;AI一站式工具链向上提供数据集、模型和智能体研发管理。打通了设备与智能体应用之间的通道,提高设备的资源利用率,保障应用稳定运行。
Q:什么是异构算力?
异构算力通常指由不同架构、不同类型或不同厂商的 CPU、GPU 等计算资源共同组成的算力环境。
Q:异构算力为什么需要统一管理和调度?
当不同设备分散在多个地区、机房和项目中时,统一管理可以减少资源信息分散、权限不清和调度困难等问题。
Q:衍生智算如何管理异构算力?
通过资源规格、节点纳管、组织权限、智算集群、算力调度、GPU 共享和资源监控等能力,对不同计算资源进行统一管理和使用。